“私有 AI”听起来可能像营销用语。但实际上,它的含义相当具体:回答您问题的软件运行在您自己掌控的电脑上,而不是在别人位于海外的服务器上。下面看看它具体是什么样子。
硬件
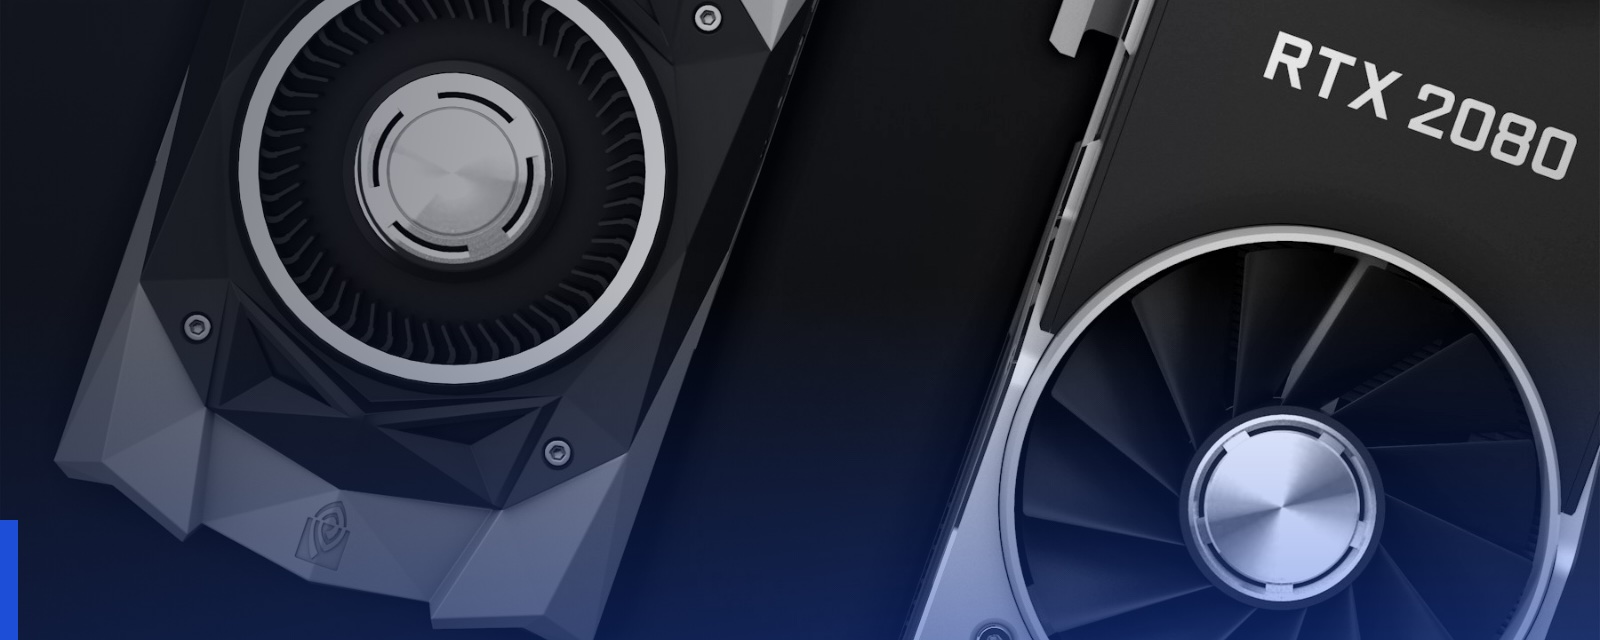
对一般的小型机构来说,就是一台安静的、台式机大小的服务器,配备一块高性能的 NVIDIA 显卡(GPU)和加密存储。它放在网络机柜里或办公桌下,接入普通的办公网络,满负荷运行时的耗电量和一台游戏电脑差不多。日常无需任何人去动它。
之所以需要 GPU,是因为语言模型的底层其实是海量的算术运算。显卡可以并行完成这些运算,速度快到回答能以正常阅读的速度呈现。
不想在现场放硬件的机构,也可以在澳大利亚数据中心的专属服务器上使用同样的配置。“专属”意味着不与他人共用:服务器上不运行任何其他人的工作负载。
模型
它的“大脑”是一个开放权重的语言模型。不少公司和研究机构会公开发布模型,其权重(也就是让模型运作的那些学习得来的数值)任何人都可以下载和运行。知名的模型系列包括 Llama、Qwen 和 Mistral。
模型下载后,完全在本地服务器上运行。它不会“回传数据”,回答问题时不需要联网,您输入的任何内容都不会发回给训练它的公司。说得直白一点,您可以拔掉网线,它照样能用。
搜索您自己的文件
一个只知道训练时所学内容的助手,对机构的日常工作帮助不大。真正有用的,是能针对您自己的文件提问:“2023 年我们就租约问题给这位客户提了什么建议?”或者“总结一下这位患者最近三封专科医生来信。”
这是通过一种通常称为检索增强生成(retrieval-augmented generation,简称 RAG)的技术实现的:
- 服务器为您选定的文件夹建立一个私有搜索索引,存放在同一块加密磁盘上。
- 有人提问时,服务器在这个索引中搜索最相关的段落。
- 这些段落连同问题一起交给模型,模型据此写出回答,并注明出处文件。
关键在于,搜索会遵循现有的访问权限。如果某位员工目前无权打开某个文件夹,助手也不会向他展示其中的任何内容。为了实现搜索,不会有任何内容被复制到云服务。
如何使用
员工通过网页浏览器使用,界面是一个聊天窗口,外观和使用感受都与 ChatGPT 很相似。他们用平时的机构账户登录,不需要在每台电脑上安装应用。
实事求是地说,它有局限
开放权重模型进步显著,在起草、总结、改写和搜索等日常工作上已经非常能干。但如果假装两者之间毫无差距,那就是误导。
- 最难的推理任务。领先的前沿云端模型在冗长的多步骤问题和最困难的分析上仍然更胜一筹。
- 通用知识的广度。更大的云端模型对更多领域了解得更多。对机构工作而言,这一点没那么重要,因为关键的知识就在您自己的文件里。
- 它终究是 AI。它可能会自信满满地给出错误答案。所有输出都是草稿,须由具备资质的人员审核,不构成临床或法律建议。
- 它本身并不能让您合规。把数据留在内部可以消除一大类风险,但政策、培训和良好的判断依然重要。
适合哪些机构
在以下情况下,私有服务器最有意义:处理的信息确实敏感(健康记录、受特权保护的法律材料、财务信息);机构希望对“我们的数据去了哪里?”有一个简单明了的答案;员工已经在使用 AI,需要一个经过批准、同样方便的工具。如果一家机构只处理公开信息,一个信誉良好的云端订阅服务可能就足够了,我们也会如实告知。